Loading...🤓
19. Mai 2026
Vergleichende Fragen wie "Was unterscheidet RAG-Variante X von Y?" bringen Standard-RAG ins Stolpern. Agentic RAG zerlegt sie in Teilrecherchen — wir zeigen, wie unsere Implementierung im rag-service das in iterativen Schritten löst.
Agentic RAG ist kein einzelnes Muster, sondern ein Spektrum. Am einen Ende steht mehrstufiges Retrieval, bei dem ein LLM eine komplexe Frage in Teilfragen zerlegt, diese nacheinander recherchiert und seine eigenen Zwischenergebnisse prüft. Am anderen Ende stehen voll orchestrierte Multi-Agenten-Systeme, in denen ein Orchestrator eigenständige Sub-Agenten mit eigenen Werkzeugen, Datenquellen und Spezialisierungen koordiniert. Beides wird in der Literatur unter dem Begriff Agentic RAG gefasst — entscheidend ist, wo auf diesem Spektrum man sich verortet.
Unsere Implementierung deckt den ersten Teil dieses Spektrums ab: iteratives, selbstkontrolliertes Retrieval über eine einzelne Wissensbasis mit Websuche als Fallback. Das ist kein vollständiges Multi-Agenten-System, aber bereits mächtig genug, um vergleichende und analytische Fragen zu beantworten, an denen eine einfache RAG-Pipeline scheitert.
Am Anfang steht die Query-Zerlegung. Ein lokales Grading-LLM — bei uns ein Mistral Small 3.1 (24B), der auf unserem eigenen Inferenz-Host läuft — wird per deutschsprachigem Prompt angewiesen, die ursprüngliche Frage in zwei bis vier unabhängige Teilfragen zu zerlegen. Antwortet das Modell fehlerhaft oder liefert Unsinn, greift ein Fail-Open-Mechanismus: Die Originalfrage wird dann selbst als einzige Teilfrage behandelt. Der Prozess läuft weiter, auch wenn das Grading-Modell ausfällt.
Anschließend beginnt die eigentliche Recherche: Jede Teilfrage wird mit intfloat-multilingual-e5-large eingebettet und gegen Qdrant abgefragt. Liefert die Vektorsuche nichts oder liegt der Top-Score unter dem CRAG-Schwellenwert von 0,3, ergänzt das System für diese Teilfrage zusätzlich eine SearXNG-Websuche. Die niedrig bewerteten Qdrant-Treffer werden dabei nicht verworfen, sondern mit den Web-Ergebnissen zusammengeführt, sodass auch Teiltreffer in die Synthese einfließen. Die gefundenen Dokumente werden anschließend über alle Teilfragen hinweg per URL dedupliziert, sodass dieselbe Quelle nicht mehrfach im finalen Kontext landet.
Nach jeder Iteration folgt eine Vollständigkeitsprüfung. Das Grading-LLM wird erneut gefragt — diesmal auf Deutsch, mit einer erwarteten Antwort „ja“ oder „nein“ — ob die bisher gesammelten Belege ausreichen, um die Originalfrage zu beantworten. Bei einem Modellfehler terminiert das System fail-open, damit ein instabiles Grading-Modell den Loop nicht endlos am Leben hält. Antwortet das Modell mit „nein“, generiert es zwei bis drei neue Teilfragen, die gezielt auf die noch offenen Aspekte zielen. Diese werden dann in der nächsten Iteration recherchiert. Eine harte Obergrenze von drei Iterationen verhindert Endlosschleifen, auch wenn das Grading-Modell hartnäckig „nein“ meldet.
Sobald die Schleife endet, werden alle deduplizierten Dokumente und Web-Ergebnisse an das eigentliche Antwort-LLM übergeben. Ein Multi-Source-Synthese-Prompt weist das Modell an, Informationen aus verschiedenen Quellen zu verbinden, Widersprüche explizit zu benennen und alle Aussagen als Markdown-Links zu zitieren. Trainingswissen ist dabei ausdrücklich verboten — die Antwort darf nur aus dem gelieferten Kontext stammen. Begleitet wird der gesamte Ablauf von Server-Sent-Events: Unsere Chat-Oberfläche erhält Schritt-Events wie query_decomposed, subquestion_started, subquestion_completed, completeness_checked und web_search_completed und rendert daraus eine Live-Animation des Recherche-Prozesses. Der Nutzer sieht in Echtzeit, was der Agent gerade tut.
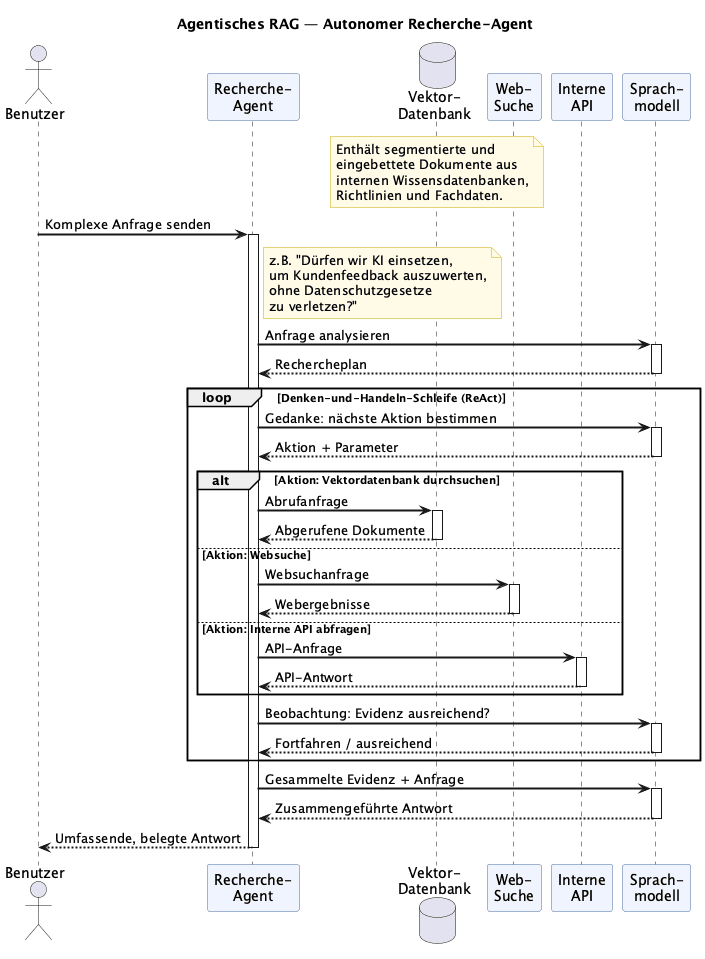
Unsere Wissensbasis ist auf die deutsche Energiewende ausgerichtet — erneuerbare Erzeugung, Netzstabilität, Speichertechnologien und den regulatorischen Rahmen. Eine realistische Frage für dieses Corpus lautet: „Welche Technologie eignet sich besser zur Stabilisierung des deutschen Stromnetzes — gasbetriebene Spitzenlastkraftwerke oder Großbatteriespeicher? Bitte mit Quellen abwägen.“ Eine einfache RAG-Pipeline tut sich mit dieser Art von Frage grundsätzlich schwer, unabhängig davon, was gerade im Index liegt: Die Top-Treffer gruppieren sich tendenziell um die Technologie, die im Corpus am Tag X am stärksten vertreten ist, und der eigentliche Vergleichswinkel — wann gewinnt welche Option — bekommt von sich aus selten einen ausgewogenen Retrieval-Pass.
Unser agentischer Modus zerlegt die Anfrage in eigenständige Teilfragen — typischerweise eine pro verglichener Technologie und eine für den eigentlichen Vergleich, zum Beispiel: „Welche Rolle spielen Gaskraftwerke bei der Stabilisierung des deutschen Stromnetzes?“, „Welche Rolle spielen Batteriespeicher bei der Stabilisierung des deutschen Stromnetzes?“ und „Wie schneiden Gaskraftwerke und Batterien in Bezug auf Kosten, Reaktionszeit und CO2-Bilanz im deutschen Markt im Vergleich ab?“. Jede Teilfrage läuft als eigene Qdrant-Suche gegen den Energie-Korpus und bringt das zurück, was zum jeweiligen Aspekt aktuell indiziert ist — unabhängig davon, was die anderen Teilfragen finden. Die Vollständigkeitsprüfung entscheidet anschließend, ob alle Blickwinkel abgedeckt sind oder ob eine weitere Iteration mit neuen Gap-Fragen nötig ist. Sobald die Schleife terminiert, fügt das Antwort-LLM die einzelnen Quellenbündel zu einer strukturierten Vergleichsantwort mit sauberen Zitaten zusammen — getrenntes Retrieval pro Aspekt, Deduplizierung über alle Aspekte hinweg und am Ende eine beleggebundene Synthese.
Der größte Gewinn ist die Fähigkeit, vergleichende und analytische Fragen zu beantworten, an denen ein einzelner Retrieval-Schritt zwangsläufig scheitert. Dadurch, dass jede Teilfrage einen eigenen Retrieval-Durchlauf bekommt, deckt das System auch Anfragen ab, die mehrere Facetten einer Wissensbasis gleichzeitig berühren. Die Live-Animation per SSE macht den Prozess für Nutzer transparent — sie sehen, dass tatsächlich recherchiert wird und nicht nur eine schwarze Box antwortet. Die konsequente Fail-Open-Philosophie sorgt dafür, dass ein wackelndes Grading-Modell die Antwort nie blockiert, sondern höchstens den zusätzlichen Mehrwert verringert. Und wo die eigene Wissensbasis Lücken hat, springt der SearXNG-Fallback automatisch ein.
Der Preis für diese Fähigkeiten ist Latenz. Typische Antwortzeiten liegen im agentischen Modus bei 8 bis 15 Sekunden, während reines Corrective RAG im selben System mit 5 bis 8 Sekunden auskommt. Das liegt an den zusätzlichen LLM-Aufrufen: Query-Zerlegung, Vollständigkeitsprüfung und gegebenenfalls Gap-Question-Generation kommen obendrauf. Außerdem steht und fällt die Qualität der gesamten Antwort mit der Qualität der Zerlegung — wenn das Grading-LLM die Originalfrage schlecht aufspaltet, suchen die nachfolgenden Retrieval-Schritte an den falschen Stellen, und die Synthese am Ende kann diesen Fehler nicht mehr ausgleichen. Für einfache Faktenfragen ist der Modus schlicht überdimensioniert.
Unsere Umsetzung ist bewusst einfach gehalten: ein einzelner Vektorspeicher, mehrstufiges Retrieval, eine Synthese am Ende. Das vollständige Bild von Agentic RAG, wie es Singh et al. 2025 in ihrer Survey zeichnen, geht deutlich weiter. Der nächste Schritt wären mehrere domänenspezialisierte Sub-Agenten — ein Agent für die Produktdokumentation, einer für CRM-Daten, einer für Preise, einer für technische Spezifikationen. Jeder dieser Agenten hätte seine eigene, auf seine Datenquelle zugeschnittene Retrieval-Strategie.
Darüber hinaus könnten diese Sub-Agenten eigene Werkzeuge bekommen, die weit über Vektorsuche hinausgehen: direkte API-Aufrufe, SQL-Abfragen gegen strukturierte Datenbanken, Taschenrechner für numerische Auswertungen, sogar Code-Ausführung in einer Sandbox. Ein echter Orchestrator würde dann auf Basis der Anfrage dynamisch planen, welche Agenten in welcher Reihenfolge aufgerufen werden und welche Schritte sich parallelisieren lassen — statt die Schritte wie bei uns sequentiell durchzurechnen. Die Tool-Auswahl erfolgt in dieser Ausbaustufe per Function Calling: Der Orchestrator entscheidet dynamisch, welches Werkzeug zu welcher Teilfrage passt, statt sich auf eine feste Pipeline zu verlassen.
Und schließlich fehlt uns das, was ein echtes Multi-Agenten-System auszeichnet: Konsistenzprüfungen zwischen Agenten. Wenn zwei Sub-Agenten zu einem Thema überlappende oder widersprüchliche Informationen liefern, müsste der Orchestrator das erkennen und auflösen — etwa indem er eine dritte Quelle befragt oder die Widersprüche in der Antwort explizit markiert. Unser System erbt diese Verantwortung bislang vom Synthese-Prompt des finalen LLMs, was funktioniert, aber längst nicht so strukturiert ist wie ein dedizierter Reconciliation-Schritt. Für ein Unternehmen, das heterogene Datensilos verbindet, ist dieser Ausbaupfad der nächste logische Schritt.
Aktivieren Sie den agentischen Modus, wenn Ihre Nutzer vergleichende, mehrdimensionale oder rechercheartige Fragen stellen, die verschiedene Aspekte Ihrer Wissensbasis gleichzeitig berühren. Für einfache Faktenfragen bleibt Corrective RAG die bessere Wahl — schneller, günstiger, ausreichend genau. Der Mehraufwand lohnt sich erst dort, wo mehrere Teilthemen sauber gegeneinander abgewogen werden müssen und wo Nutzer eine strukturierte Antwort mit belegten Einzelaussagen erwarten.
Singh et al. — Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG (2025)
https://www.mbnsoftware.de/de/chat?rag=agentic
