Loading...🤓
14. April 2026
Vektorsuche findet ähnliche Texte, aber keine expliziten Beziehungen. GraphRAG modelliert Entitäten und ihre Verbindungen als Graphen — und beantwortet damit Fragen, die mehrere Hops durch strukturiertes Wissen erfordern.
Anstatt Dokumente als isolierte Chunks abzulegen, werden Personen, Organisationen und Konzepte als Knoten und ihre Beziehungen als Kanten in einer Graphdatenbank gespeichert. Auf eine Frage wie "Welche Projekte hat der CTO von Unternehmen X geleitet?" kann das System die Kette Person → Rolle → Unternehmen → Projekte direkt traversieren — ein Reasoning-Schritt, den Vektorähnlichkeit allein nicht abbilden kann.
Statt eine eigene Graphdatenbank mit Community-Detection-Pipeline zu betreiben, läuft GraphRAG hier auf der bereits vorhandenen Vektor-Infrastruktur (Qdrant + MongoDB). Eine Anfrage durchläuft fünf Schritte. Erstens liefert Qdrant per Embedding-Suche die fünf relevantesten Dokumente — derselbe Retrieval-Schritt wie bei Standard-RAG. Zweitens prüft das System für jedes Dokument, ob in MongoDB bereits extrahierte Tripel (Subjekt | Prädikat | Objekt) hinterlegt sind; diese werden vorab durch einen Backfill-Job nach jedem Re-Crawl angelegt. Fehlt ein Dokument im Speicher, extrahiert ein kleineres Grading-LLM die Tripel live aus dem Text — der Modus bleibt damit auch für frisch indexierte Inhalte sofort funktionsfähig. Drittens bildet die Vereinigung aller Tripel eine flüchtige, anfragespezifische Adjazenzliste (eine Tabelle, die jeder Entität alle Tripel zuordnet, in denen sie als Subjekt oder Objekt vorkommt), und Entitäten werden zum Vergleichen kleingeschrieben, eine Alias-Auflösung gibt es bewusst nicht. Viertens identifiziert dasselbe Grading-LLM die Entitäten in der Nutzerfrage und startet von dort eine Breitensuche (Breadth-First Search, kurz BFS): erst werden alle direkten Nachbarn der Frage-Entitäten besucht, dann deren Nachbarn, schichtweise — gedeckelt auf zwei Hops und 30 Beziehungen für den Prompt. Fünftens erhält das eigentliche Antwort-LLM die gefundenen Beziehungsketten zusammen mit den Originaldokumenten und liefert eine Antwort, die beides referenziert. Findet die BFS keinen Treffer im Graphen, fällt das System auf alle extrahierten Tripel oder im Notfall auf die reine Vektorsuche zurück, ohne den Nutzer zu blockieren.
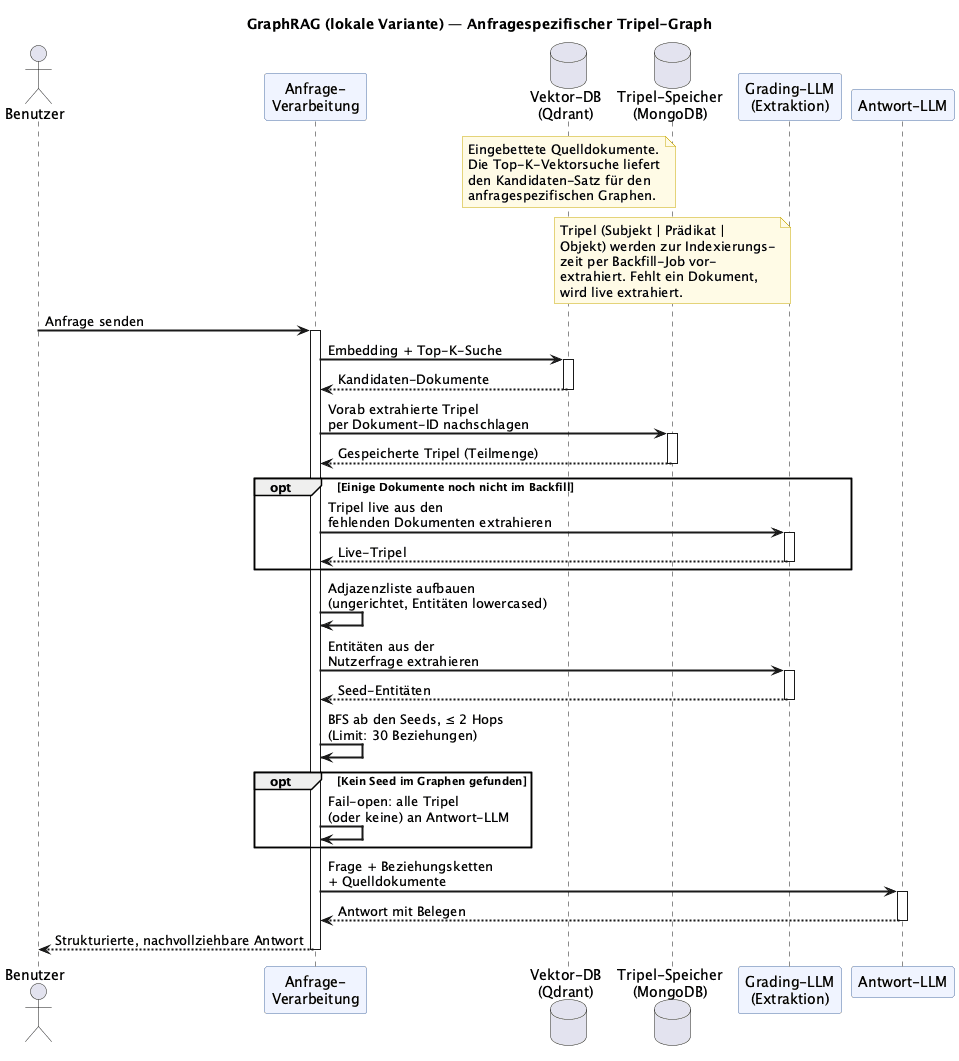
Die Original-Architektur von Microsoft setzt auf eine dedizierte Graphdatenbank, einen periodischen Leiden-Clustering-Lauf über das gesamte Korpus und vorgenerierte Community-Berichte mit Map-Reduce-Synthese für globale Fragen. Das ist eindrucksvoll — und für ein Korpus dieser Größe deutlich überdimensioniert. Die hier beschriebene Variante liefert den Kerngewinn von GraphRAG, also explizite Beziehungen statt reiner Vektorähnlichkeit, auf der vorhandenen Qdrant- und MongoDB-Infrastruktur, ohne ein zusätzliches System zu betreiben oder einen weiteren regelmäßigen Cluster-Job zu verantworten. Der Preis dafür: kein globaler Map-Reduce-Modus, keine Community-Zusammenfassungen, Reasoning bleibt auf zwei Hops begrenzt. Für die typischen Wissensfragen, die hier auftreten — Beziehungsketten zwischen wenigen Entitäten, sauber innerhalb der RAG-Architekturen-Inhalte verortet — ist das ein vertretbarer Kompromiss; bei Korpora mit Millionen Dokumenten oder Anforderungen an globale Synthese sollte man die volle Pipeline in Betracht ziehen.
Stellen Sie sich die Frage "Wie wirken sich Leitzinsentscheidungen der Zentralbank auf die Bewertung von Tech-Startups aus?" vor. Eine vektorbasierte Suche liefert Dokumente, die beide Themen erwähnen. GraphRAG verfolgt stattdessen eine Beziehungskette: Zentralbank entscheidet über den Leitzins, der wirkt sich auf die Kapitalverfügbarkeit aus, die beeinflusst die Risikofinanzierung, die schlägt sich in den Bewertungen früher Phasen nieder. Die Antwort entsteht aus der Beziehungskette selbst, nicht aus Dokumentähnlichkeit.
Reasoning über Ursache und Wirkung ist deutlich zuverlässiger als reine Vektorsuche, weil die Beziehungskette aus expliziten Tripeln stammt und nicht aus oberflächlicher Ähnlichkeit. Multi-Hop-Verknüpfung ist nativ möglich: Das System kann Informationen über Knoten hinweg verbinden, die in keinem einzelnen Dokument gemeinsam vorkommen. Und die Antworten sind sehr gut erklärbar — jede Schlussfolgerung lässt sich über den Graphen bis zu den Quelldokumenten zurückverfolgen, aus denen die Tripel stammen, und falsch-positive Treffer durch nur scheinbare semantische Ähnlichkeit gehen merklich zurück.
Aufbau und Pflege des Tripel-Bestands erfordern Vorinvestitionen. Die LLM-gestützte Extraktion kann inkonsistent sein und einen unvollständigen oder verrauschten Graphen liefern. Die Indexierungskosten sind deutlich höher als bei reiner Vektorsuche, da jedes Dokument analysiert statt nur eingebettet werden muss. Den Graphen aktuell zu halten, wenn sich die Quellen ändern, heißt: den Backfill erneut laufen lassen — für dieses Korpus vertretbar, aber nicht kostenlos. Für sehr offene oder rein konversationelle Anfragen ist die Architektur überdimensioniert.
GraphRAG ist nur so gut wie der Wissensgraph, auf dem es aufsetzt — und der ist nur so gut wie die Quelldokumente. Drei Punkte sind in der Praxis entscheidend. Erstens müssen Beziehungen im Text explizit benannt sein: Ein Satz wie "Die EZB hat den Leitzins erhöht" liefert ein klares Tripel; eine vage Formulierung wird vom Extraktor übersehen. Zweitens muss die Entitätsbenennung im gesamten Korpus konsistent sein. Tauchen "EZB" und "Europäische Zentralbank" gemischt auf, entstehen zwei getrennte Knoten — eine automatische Alias-Auflösung gibt es nicht, der Graph zerfällt. Drittens müssen die Textchunks groß genug sein, um den Beziehungssatz vollständig zu enthalten; wird er beim Chunking zerschnitten, fehlt das Tripel im Graphen. Ein zentraler Wartungsschritt ist daher die Tripel-Extraktion vorab als Batch-Job (Backfill) nach jedem Re-Crawl der Quellen, damit produktive Anfragen nicht jedes Mal die teure LLM-Extraktion bezahlen und Lücken im Graphen vor den Nutzern sichtbar werden.
GraphRAG ist die richtige Wahl, wenn Ihre Wissensbasis reich an Beziehungen ist und Nutzer regelmäßig Fragen stellen, die mehrere Entitäten verknüpfen. Typische Anwendungsfälle: Compliance-Systeme, in denen regulatorische Verknüpfungen verfolgt werden müssen, Forschungsplattformen, die wissenschaftliche Zitationsnetzwerke durchsuchen, oder interne Unternehmens-Wikis, in denen Personen, Projekte und Abteilungen vernetzt sind. Überall dort, wo die Daten eine reiche relationale Struktur haben und die Anwendungsfälle kausales oder Multi-Hop-Reasoning erfordern, liefert GraphRAG Fähigkeiten, die kein vektorbasierter Ansatz erreichen kann.
Edge et al. — From Local to Global: A Graph RAG Approach to Query-Focused Summarization (2024)
Microsoft — GraphRAG Open-Source-Implementierung (GitHub)
