
Self-RAG: Die Architektur, die ihre eigenen Antworten hinterfragt
6. März 2025
Externe Evaluatoren prüfen die Antwort erst, wenn sie schon geschrieben ist. Self-RAG verlagert die Kritik in das Modell selbst — über spezielle Reflexions-Tokens, mit denen das LLM seinen eigenen Output während der Generierung bewertet.
Was es ist
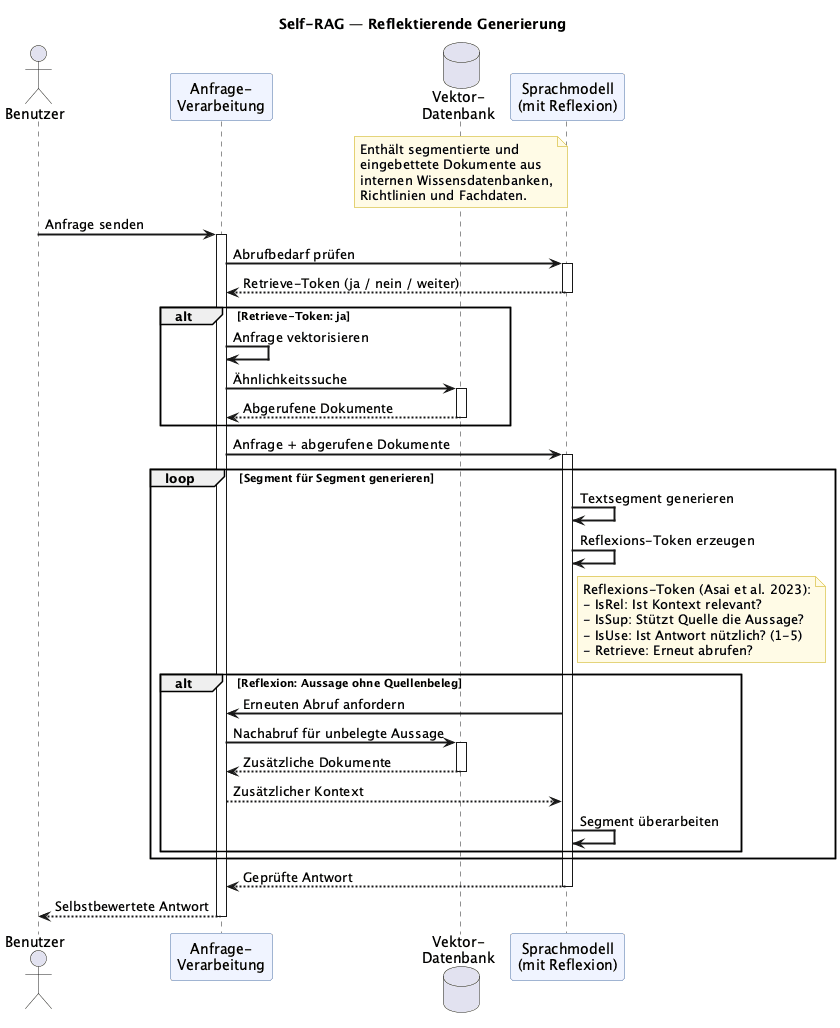
Beim Training lernt das Modell vier Steuer-Tokens: Retrieve (muss ich überhaupt etwas abrufen?), ISREL (sind die Treffer relevant?), ISSUP (decken die Belege meine Aussage?), ISUSE (ist die Antwort nützlich?). Diese Tokens funktionieren wie ein innerer Monolog, der jede Stufe der Antwort prüft, bevor sie den Nutzer erreicht.
Wie es funktioniert
Der Prozess verläuft in mehreren Schritten. Zunächst generiert das Modell ein Retrieve-Token, das angibt, ob Retrieval nötig ist. Falls ja, werden Dokumente abgerufen und jedes einzeln mit einem ISREL-Token bewertet (relevant oder nicht). Für jedes relevante Dokument generiert das Modell eine Teilantwort und prüft mit ISSUP, ob diese durch das Dokument gestützt wird. Abschließend bewertet ISUSE die Gesamtqualität der Antwort. Nur wenn alle Prüfungen bestanden werden, wird die Antwort an den Nutzer ausgegeben.
Stärken
Self-RAG erreicht eine deutlich höhere faktische Genauigkeit als Standard-RAG, weil es irrelevante Dokumente und ungestützte Aussagen aktiv aussortiert. Das Modell vermeidet unnötige Retrieval-Aufrufe, wenn die Frage aus dem Trainingswissen beantwortbar ist, was Latenz und Kosten spart. Die Reflexions-Tokens bieten außerdem hervorragende Erklärbarkeit — man kann genau nachvollziehen, warum das Modell bestimmte Dokumente akzeptiert oder abgelehnt hat.
Schwächen
Der größte Nachteil ist der Trainingsaufwand. Self-RAG erfordert ein speziell feinabgestimmtes Modell, das die Reflexions-Tokens korrekt generieren kann. Dies macht es deutlich aufwändiger als Architektur-basierte Ansätze, die mit jedem LLM funktionieren. Außerdem kann eine zu strenge Selbstbewertung dazu führen, dass das Modell korrekte Antworten verwirft, weil es sie nicht vollständig durch Dokumente belegen kann.
Wann Sie es einsetzen sollten
Self-RAG eignet sich für Anwendungen, bei denen faktische Genauigkeit oberste Priorität hat und Sie bereit sind, in das Training eines spezialisierten Modells zu investieren. Es ist besonders wirkungsvoll in Wissensdomänen mit gemischten Anforderungen — wenn manche Fragen Retrieval benötigen und andere nicht.
Quellen
Asai et al. — Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection (2023)