
Standard RAG: Das Fundament, das man nicht überspringen sollte
2. März 2025
Bevor Sie über exotische RAG-Varianten nachdenken, müssen Sie das Fundament beherrschen. Standard RAG ist die einfachste Pipeline und der Maßstab, an dem alle weiterführenden Muster gemessen werden.
Was es ist
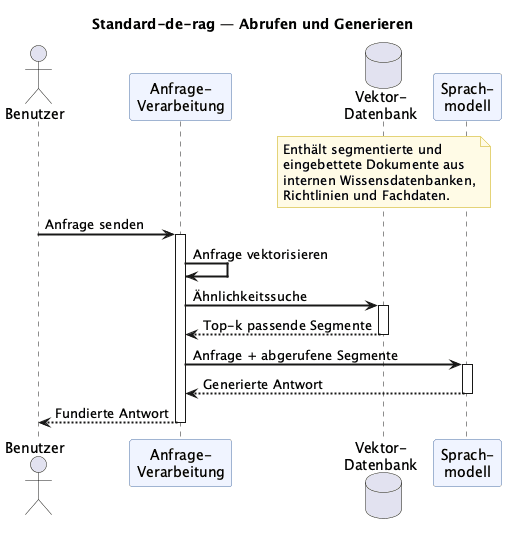
Standard RAG verbindet eine Vektordatenbank mit einem Sprachmodell über drei Schritte: die Anfrage einbetten, semantisch ähnliche Dokumente abrufen, die Antwort daraus generieren. Das Dokument-Corpus wird vorab in Chunks aufgeteilt, in Vektoren umgewandelt und in einer Datenbank wie Qdrant, Pinecone oder Weaviate abgelegt. Mehr Magie steckt nicht dahinter — und genau das macht es zum richtigen Einstiegspunkt.
Wie es funktioniert
Die Pipeline besteht aus drei Schritten. Erstens wird die Benutzeranfrage mit demselben Embedding-Modell eingebettet, das auch für die Dokumente verwendet wurde. Zweitens wird eine Ähnlichkeitssuche (typischerweise Cosine Similarity oder Dot Product) in der Vektordatenbank durchgeführt, um die Top-k relevantesten Chunks zu finden. Drittens werden diese Chunks zusammen mit der ursprünglichen Frage als Kontext an das LLM übergeben, das eine fundierte Antwort generiert.
Stärken
Standard RAG ist einfach zu implementieren und zu debuggen. Die lineare Pipeline macht jeden Schritt nachvollziehbar. Es funktioniert hervorragend für Anwendungsfälle mit einem einzigen Wissensbereich — etwa eine Produktdokumentation, ein Handbuch oder eine FAQ-Sammlung. Die Latenz ist vorhersagbar, da nur ein Retrieval-Schritt und ein LLM-Aufruf erfolgen.
Schwächen
Die größte Schwäche ist die fehlende Qualitätskontrolle nach dem Retrieval. Wenn die Vektorsuche irrelevante Chunks zurückgibt, verarbeitet das LLM sie trotzdem — was zu Halluzinationen oder fehlerhaften Antworten führen kann. Außerdem fehlt die Fähigkeit, mehrdeutige oder kontextabhängige Fragen aufzulösen, da kein Gesprächsverlauf berücksichtigt wird.
Wann Sie es einsetzen sollten
Beginnen Sie immer mit Standard RAG. Es ist das Fundament, auf dem alle anderen Muster aufbauen. Wenn die Antwortqualität ausreicht und Ihre Nutzer keine Folgefragen stellen, brauchen Sie nichts Komplexeres. Messen Sie Precision und Recall Ihrer Retrieval-Ergebnisse — erst wenn diese unter Ihren Schwellenwerten liegen, sollten Sie zu fortgeschritteneren Mustern greifen.
Quellen
Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)